小氢云商城接口抓取 Skill(技能名:orig-site-api-capture)用于从指定目标站的 Web 前端,尽量完整地抓取并导出接口路径清单。适合做小氢云商城相关对标、接口梳理与二次对接时,快速摸清站点前端实际请求了哪些 API。
传统做法是打开浏览器 Network 逐个点页面,或在打包后的 JS 里手工搜索 /api/,效率低且容易漏掉动态拼接路径。本教程介绍如何安装并使用该 Skill,完成「静态提取 + Network 补漏」两步流程,输出可复用的接口列表。
小氢云商城接口抓取 Skill 能做什么
- 静态提取前端接口:自动下载站点 JS chunk,从字符串字面量中提取接口路径,并尽量推断 GET、POST 等方法
- Network 补动态路径:配合浏览器走主导航与主流程,补齐运行时拼接、静态扫描覆盖不到的 API
- 多入口与自定义前缀:可追加用户端、H5、管理端等页面;接口不在默认
/api/下时,可用前缀参数适配 - 规范可分享:Skill 规范不写死真实业务域名,使用时由你提供当次目标站地址(BASE)
适用场景
- 需要「抓这个站的全部接口」「导出原站 API」「扫前端里的 /api」
- 对接或对标前,先整理一份尽量完整的路径清单
- 希望按固定流程执行接口抓取,而不是每次临时口述排查步骤
如何安装 Skill
- 获取本资源中的 Skill 压缩包并解压
- 将
orig-site-api-capture目录放到对应的 skills 目录(项目级或用户级均可) - 新开对话,说明需求并给出目标站
BASE,例如:「抓这个站的全部接口」
资源包内通常包含:
SKILL.md:完整执行规范scripts/capture-orig-apis.mjs:前端接口静态提取脚本
开始抓取前需要确认的参数
- BASE(必填):目标站根地址,例如
https://主机或https://主机:端口,不要带尾斜杠 - 额外入口(建议补充):用户后台、H5、管理端等路径,用
--page追加 - 接口前缀:默认
/api/;若站点接口不在该前缀下,改用--prefix - 输出目录:默认工作区下的
orig-api-capture/
未提供 BASE 时,Skill 不会开始执行。
静态提取:用脚本扫描前端 JS
在 Skill 目录中运行:
scripts/capture-orig-apis.mjs命令示例:
node <本skill目录>/scripts/capture-orig-apis.mjs --base <BASE> --out ./orig-api-capture

# 多入口示例
node .../capture-orig-apis.mjs --base <BASE> --out ./orig-api-capture --page /user/ --page /h5/
常用参数说明:
--base:必填,目标站根地址--out:输出目录--page:额外入口,可重复填写--prefix:接口前缀,默认/api/--max:最大下载 JS 数量,默认 500;结果明显偏少时可加大
输出文件说明
orig-apis.txt:每行一个接口路径,便于检索与比对orig-apis.json:路径及 methods 推断结果(可能为空)js/:下载的 chunk 缓存,二次分享 Skill 时不要带上*.html:入口页快照
Network 补漏:补齐动态拼接的 API
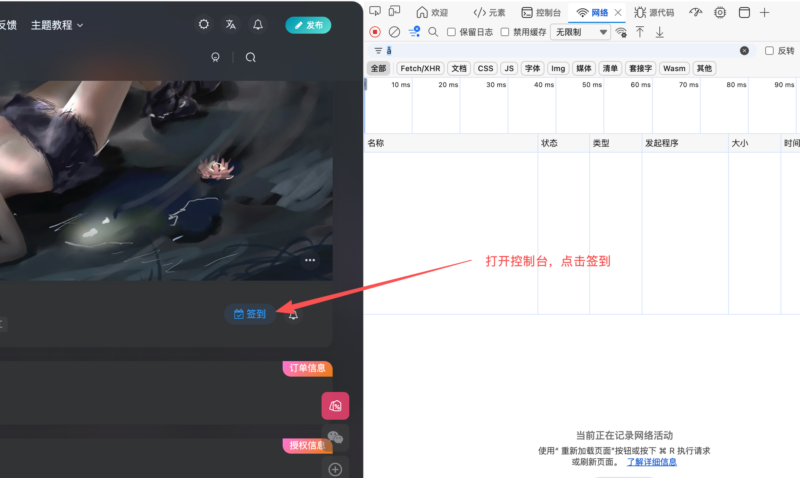
若目标是「尽量完整」的接口清单,仅做静态提取不够,还需结合浏览器 Network:
- 打开目标入口(需要登录则先完成登录)
- 按侧栏或主导航逐项进入主要页面;列表进入详情、提交类打开一次对话框,即可触发请求
- 过滤 URL 中含接口前缀的请求(默认含 api)
- 记录 METHOD 与规范化 path(去掉域名与 query;动态段可记为
/api/foo/{id}) - 合并写入
orig-apis.txt/orig-apis.json,去重后把 method 写入 methods
能力边界与常见问题
能覆盖哪些接口
字符串字面量中的 /api/...、邻近 get/post 的 method 推断,以及从 HTML 到入口 JS、再到 assets / import() / hash chunk 的持续爬取。
覆盖不了什么
纯运行时拼接且中间没有完整字面量的路径;仅存在于原生客户端中的路径(本 Skill 只扫描 Web 前端);被挑战页或人机验证拦截后的页面内容。
抓取失败怎么处理
- 脚本显示 scripts=0,或 HTML 像挑战页:改用浏览器另存入口 HTML,或关闭防护后重试;也可只依赖 Network 导出
- 接口数量很少,但站点明显是大型后台:补充
--page、加大--max、核对--prefix - Node 拉取出现 403 或超时:检查网络环境;也可对已导出的本地 js 目录再扫描
- 接口不在
/api下:将--prefix改为实际前缀,例如/v1/
使用后建议如何汇总结果
- 静态提取得到多少条,其中多少条带有 method 提示
- 是否已完成 Network 补漏,以及补了多少条
- 结果文件路径:
orig-apis.txt、orig-apis.json - 残留风险:未点到的冷门页面仍可能漏接口
使用注意
- Skill、脚本与示例中不要写死真实业务域名,统一使用当次
BASE或占位符<BASE> - 不要把某次抓取产生的
js/、orig-apis.*或带指纹的 HTML 打进对外分享包 - 未做 Network 补漏时,不要声称已经 100% 完整
- 本 Skill 职责是抓取目标站接口清单,不顺带做与本地项目的接口差集
总结
通过本篇小氢云商城接口抓取 Skill 教程,你可以按「静态扫描前端 JS + Network 补动态 API」的标准流程,更快拿到目标站接口清单,减少手工排查成本。下载资源并完成安装后,给出 BASE 即可开始使用。
THE END